למה דווקא עכשיו כדאי להסתכל על התשתית ולא רק על ה-AI?
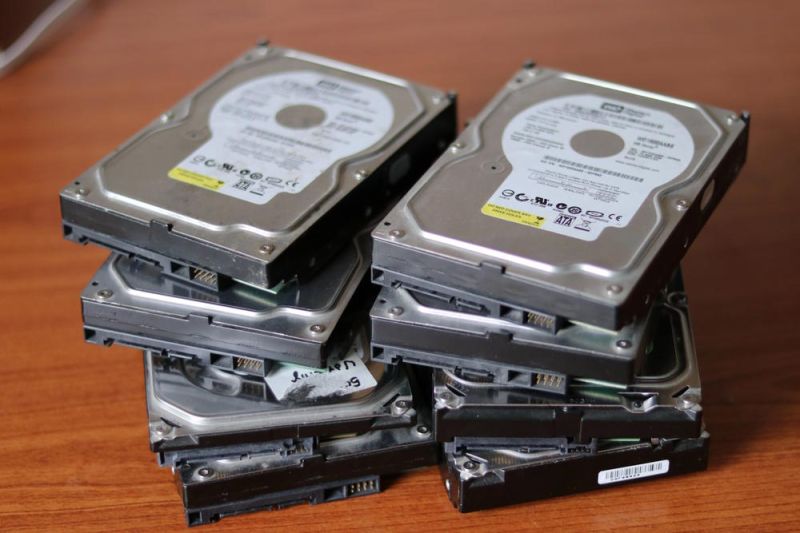
בועז זינימן, עם 30 שנה בתעשייה ושנים ב-AWS, מספר שהכנה לאירוע קרוב החזירה אותו מהשכבה של המודלים אל היסודות: מכונות, דיסקים ותקשורת. התובנה שלו פשוטה: רובנו ממקדים את תשומת הלב במה שנוצץ, והתשתית שמחזיקה הכול מקבלת יחס של "עובד, לא נוגעים".
לדבריו, גם "לא נוגעים" היא החלטה. וכמו כל החלטה, יש לה מחיר שמשולם כל חודש, בין אם מישהו שם לב ובין אם לא.
מה ההבדל בין ניהול שרתים לניהול דיסקים ותקשורת בענן?
בשרתים כבר למדנו לעבוד נכון. יש כלים למוניטורינג ול-Auto Scaling, ידע מצטבר ותמיכה של הספקים, כך שמוסיפים ומורידים משאבים כמעט ללא מגע יד. מה שלא בשימוש פשוט נעלם.
בתקשורת ובדיסקים התמונה שונה. מפזרים את המערכת בין כמה Availability Zones ואפילו ריג'נים ליתר ביטחון, וכל בייט שעובר ביניהם עולה כסף. חוקי הרשת וה-VPC רק מתווספים, כי אף אחד לא מוחק חוק שאולי משהו עדיין תלוי בו.
איך נוצר בזבוז שקט ב-Storage?
דיסקים בענן כמעט תמיד רק גדלים. להקטין דיסק דורש דיסק חדש, העתקה, השבתה ומישהו שיאשר. טכנית זה אפשרי, אבל בפועל הדיסק שהוקצה "ליתר ביטחון" לפני כמה חודשים עדיין מחויב כל חודש.
הבעיה לא נגמרת בגודל. גם ביצועים נקנים ליתר ביטחון: IOPS שהוגדרו כדי שלא יהיה צוואר בקבוק, או דיסק גדול יותר רק בשביל הביצועים, כי ככה זה עבד פעם. אף אחד לא בודק אם זה עדיין נכון, ולהוריד ביצועים בפרודקשן אף אחד לא מתנדב.
למה החשבונית משתנה גם כשההגדרות לא?
לפי בועז, ספקי הענן משנים תמחור ושיטות תמחור לעיתים קרובות, ורק לאחרונה יצא עדכון שישפיע על החשבונית של לקוחות רבים. ההגדרות שלכם נשארו אותו דבר, אבל המחיר שלהן השתנה.
בזמן שכולם עסוקים ב-AI, שכבת התשתית הזאת ממשיכה לגדול בשקט, וכל מערכת בארגון, חכמה או לא, יושבת עליה. השאלה שבועז משאיר לקוראים: מתי בפעם האחרונה מישהו אצלכם הקטין משהו ב-Storage, ומה זה דרש?